端侧 AI 的意义
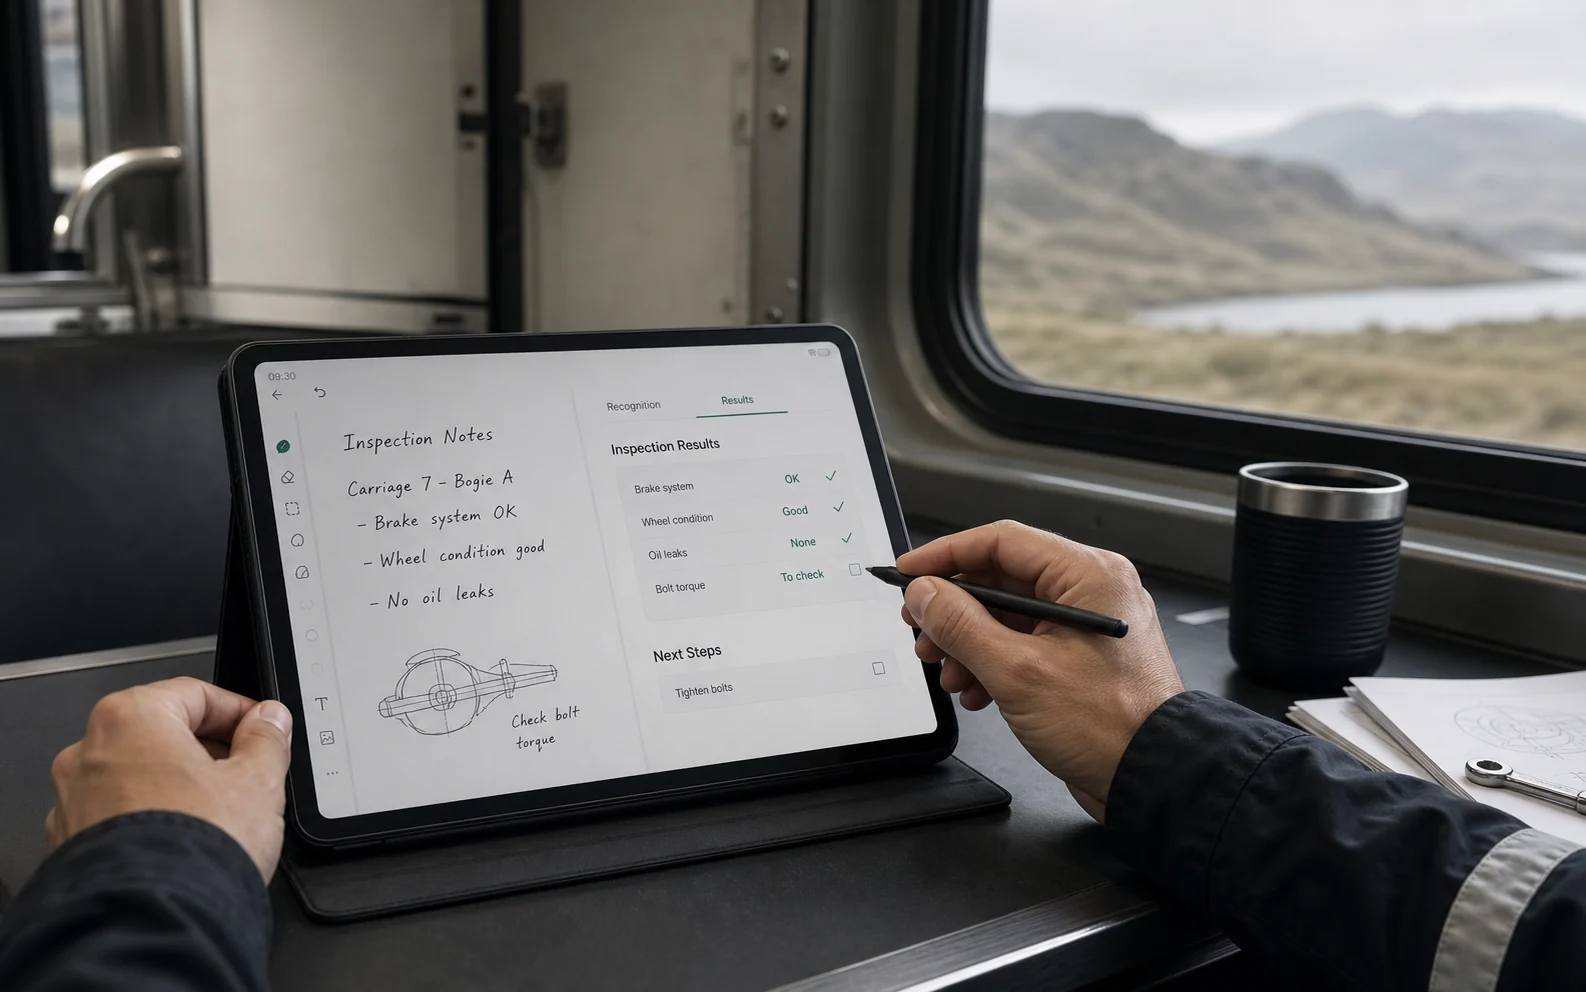
手写的价值不只在“看起来像字”,而在于它能否被搜索、编辑、计算、排版和继续使用。端侧 AI 让这些处理在没有网络时仍然发生,也让业务内容不必离开设备。
Frelax Ink 在做什么
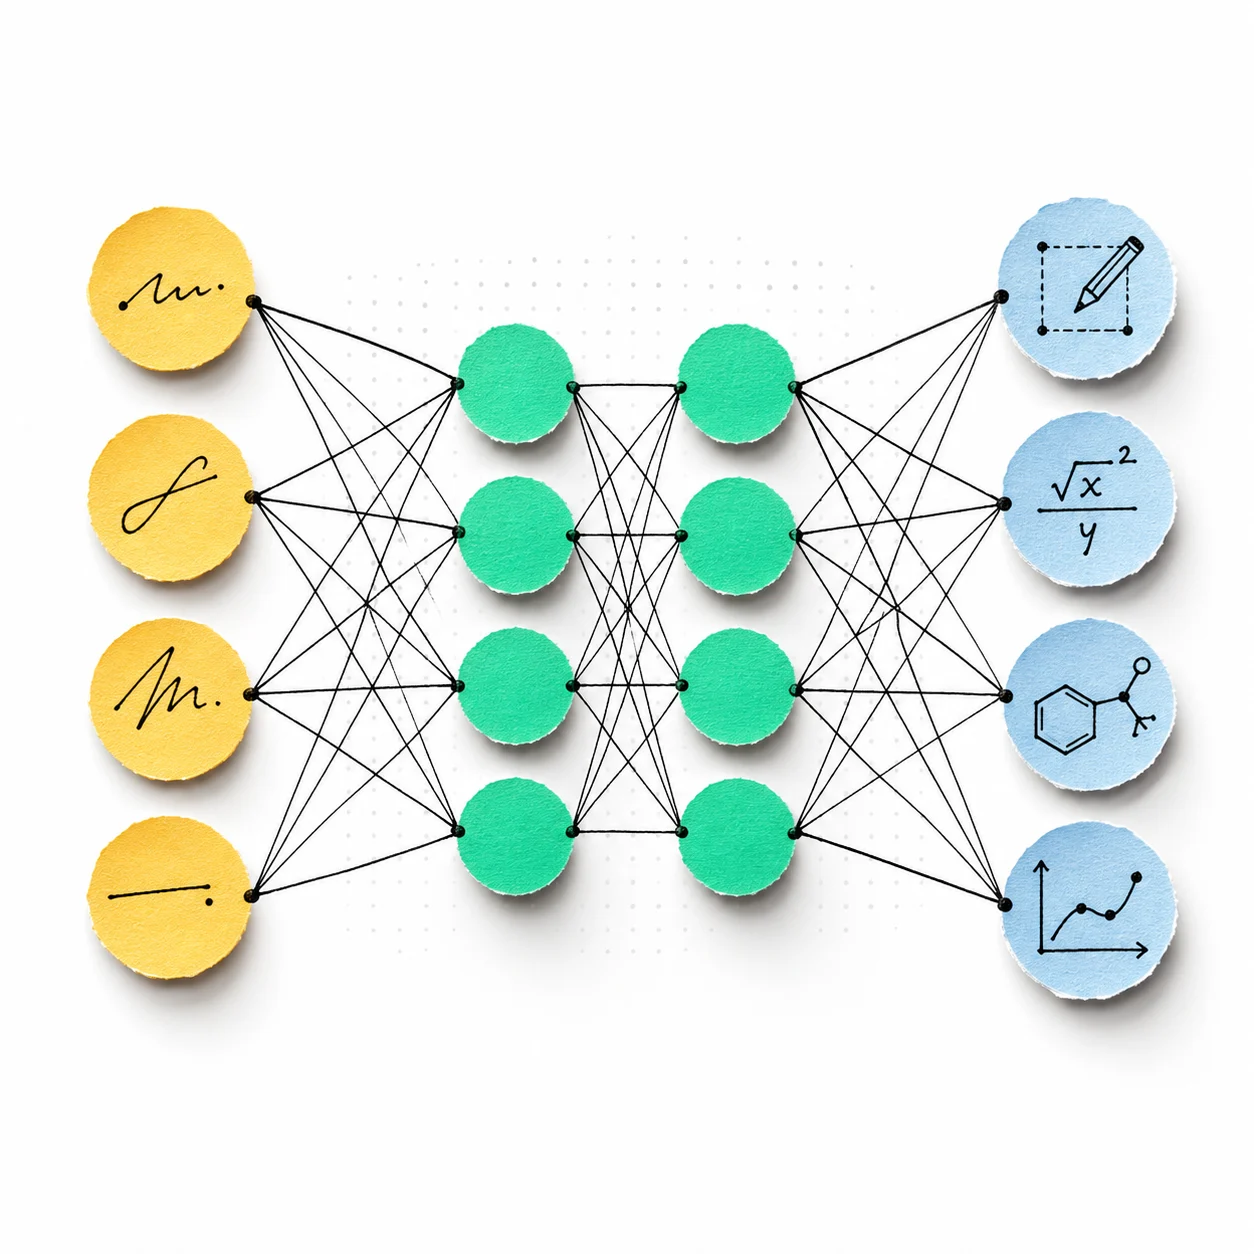
我们接收普通触控笔、电磁笔或客户自有画布产生的分笔轨迹,保留坐标、时间、行列和空间关系,再由对应任务模型输出文字、结构或可编辑对象。
当前完整工程提供 84 个语言与地区配置,并覆盖数学公式、竖式计算、化学式、2D/3D 化学结构、简谱、图形、手势、图表、复杂布局、手写美化和个人笔迹。
多语言文字识别
连续书写、多行、识别后追加、竖写、混写和叠写使用不同的页面状态与模型合同。结果不仅包含正文,也可返回候选、置信度、行区域和当前页面 revision。
二维内容识别
公式、化学结构、简谱和图表不能只按字符从左到右读取。系统需要同时判断符号是什么、符号之间有什么空间关系,以及整页应该怎样组织。
本地语言理解
离线词典、n-gram、候选分数和客户术语共同参与纠错与联想。它们只调整可解释的候选排序,不把固定答案冒充模型识别结果。
结果渲染
文字显示为可编辑文本,公式与化学式用离线排版显示,化学结构生成 2D 图和可旋转 3D,简谱生成谱面,图形与图表保留节点、连接和控制点。
真实手写为什么难
同一个字会因为书写者、笔尖、速度、压力、屏幕材质和落笔顺序产生完全不同的轨迹。可靠系统还必须在用户继续书写、撤销、清空和修改时保持页面状态一致。
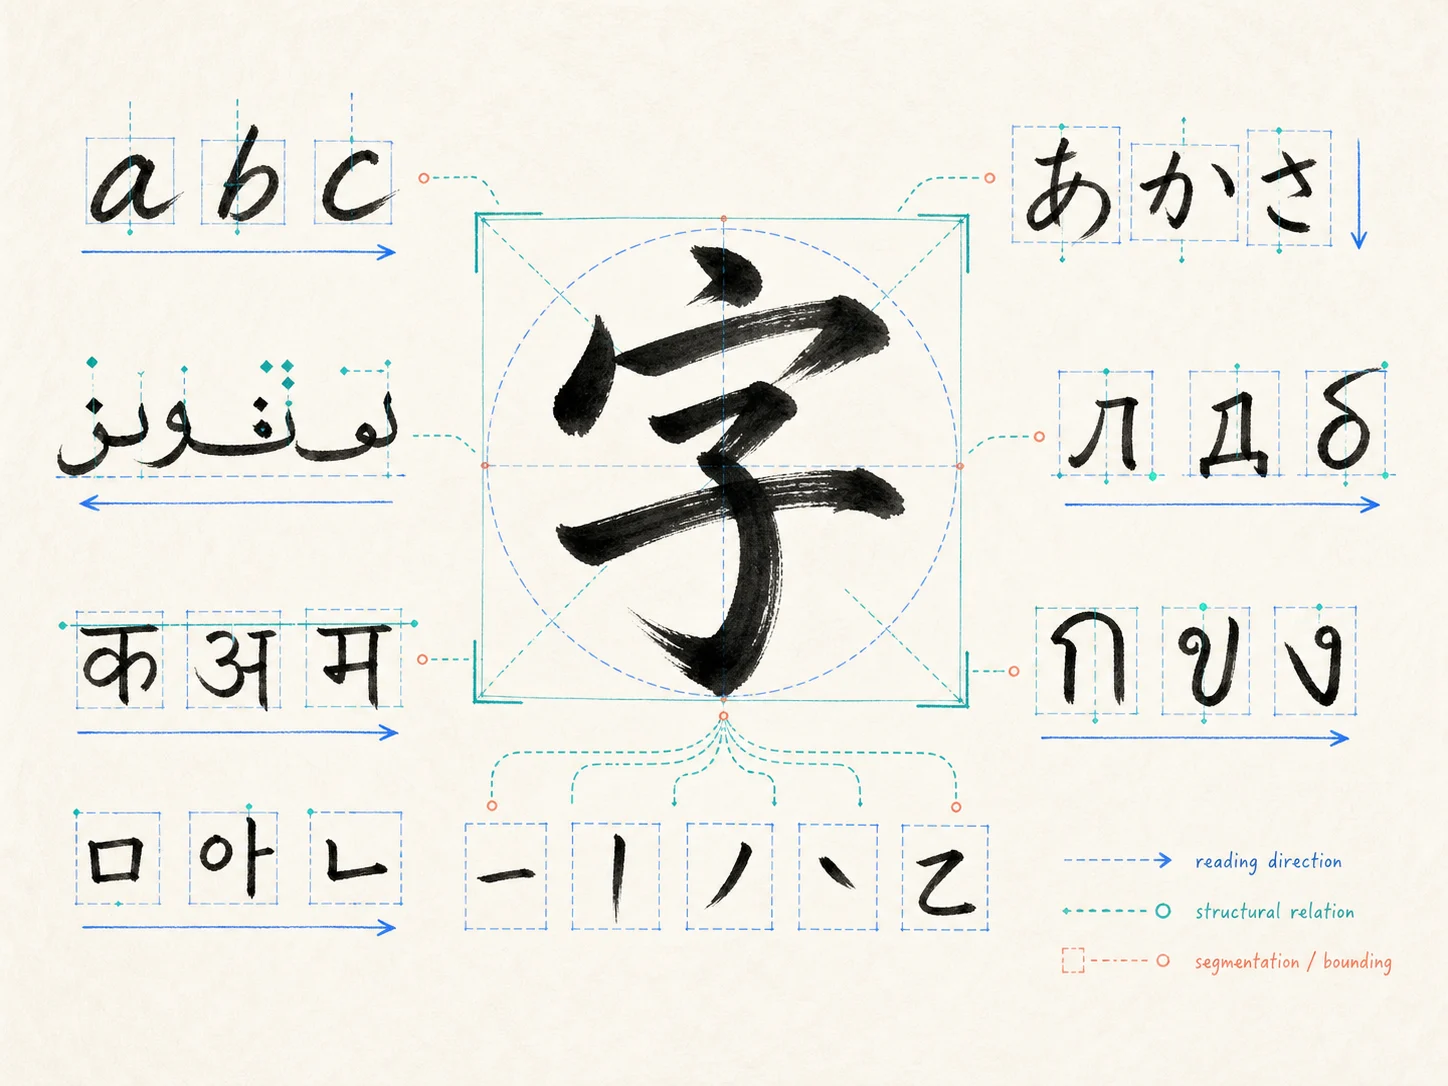
中文需要在大词表中区分结构相近的汉字;阿拉伯语、波斯语和希伯来语需要从右向左排布;日语与中文还可能竖写;附点、音符装饰、公式上下标和化学键又会延迟落笔。
因此 Frelax Ink 把输入采集、轨迹归一化、模型推理、候选融合、结构分析和结果渲染作为一条完整链路,而不是只暴露一个裸模型类别。
面向全球语言训练与部署
84 个语言与地区配置
基础 SDK 内置简体中文、繁体中文、英语、美式英语、日语和韩语;另有 78 个独立离线语言包,覆盖欧洲、亚洲、非洲和美洲多个国家与地区。
每个外置包携带自己的模型、字符词表、语法与可选语言资源,按项目安装和校验。这样既能控制产品体积,也能避免把某个国家的词典错误套用到另一个市场。
查看完整语言目录 →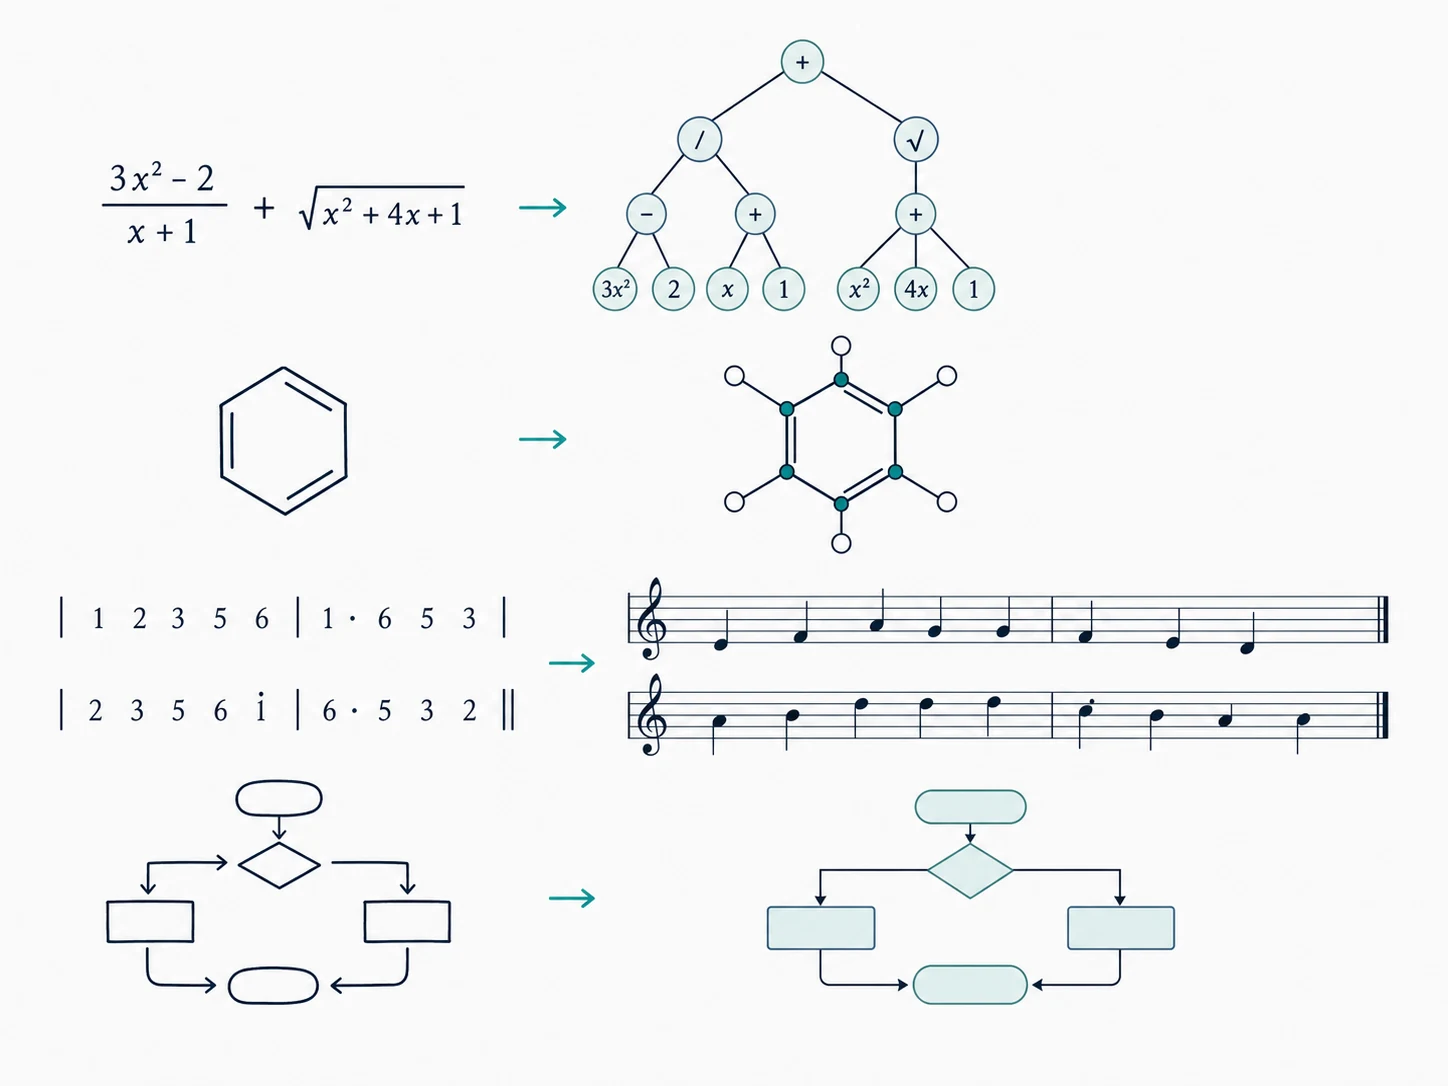
理解公式、化学、简谱与图表
数学公式与竖式计算
数学入口输出 LaTeX、token、候选和可选计算值;竖式入口按行恢复操作数、运算符和用户答案,并在本地完成计算与验算。
化学式与化学结构
化学式保留上下标和反应符号;化学结构识别原子、键、环与支链,输出 SMILES、2D/3D SDF,并在客户端生成二维图与可旋转三维结构。
简谱、图形与图表
简谱保留数字、八度点、附点、减时线、小节和谱行;图形与图表输出具名形状、节点、箭头、表格和阅读关系,结果可被选择、移动或继续编辑。
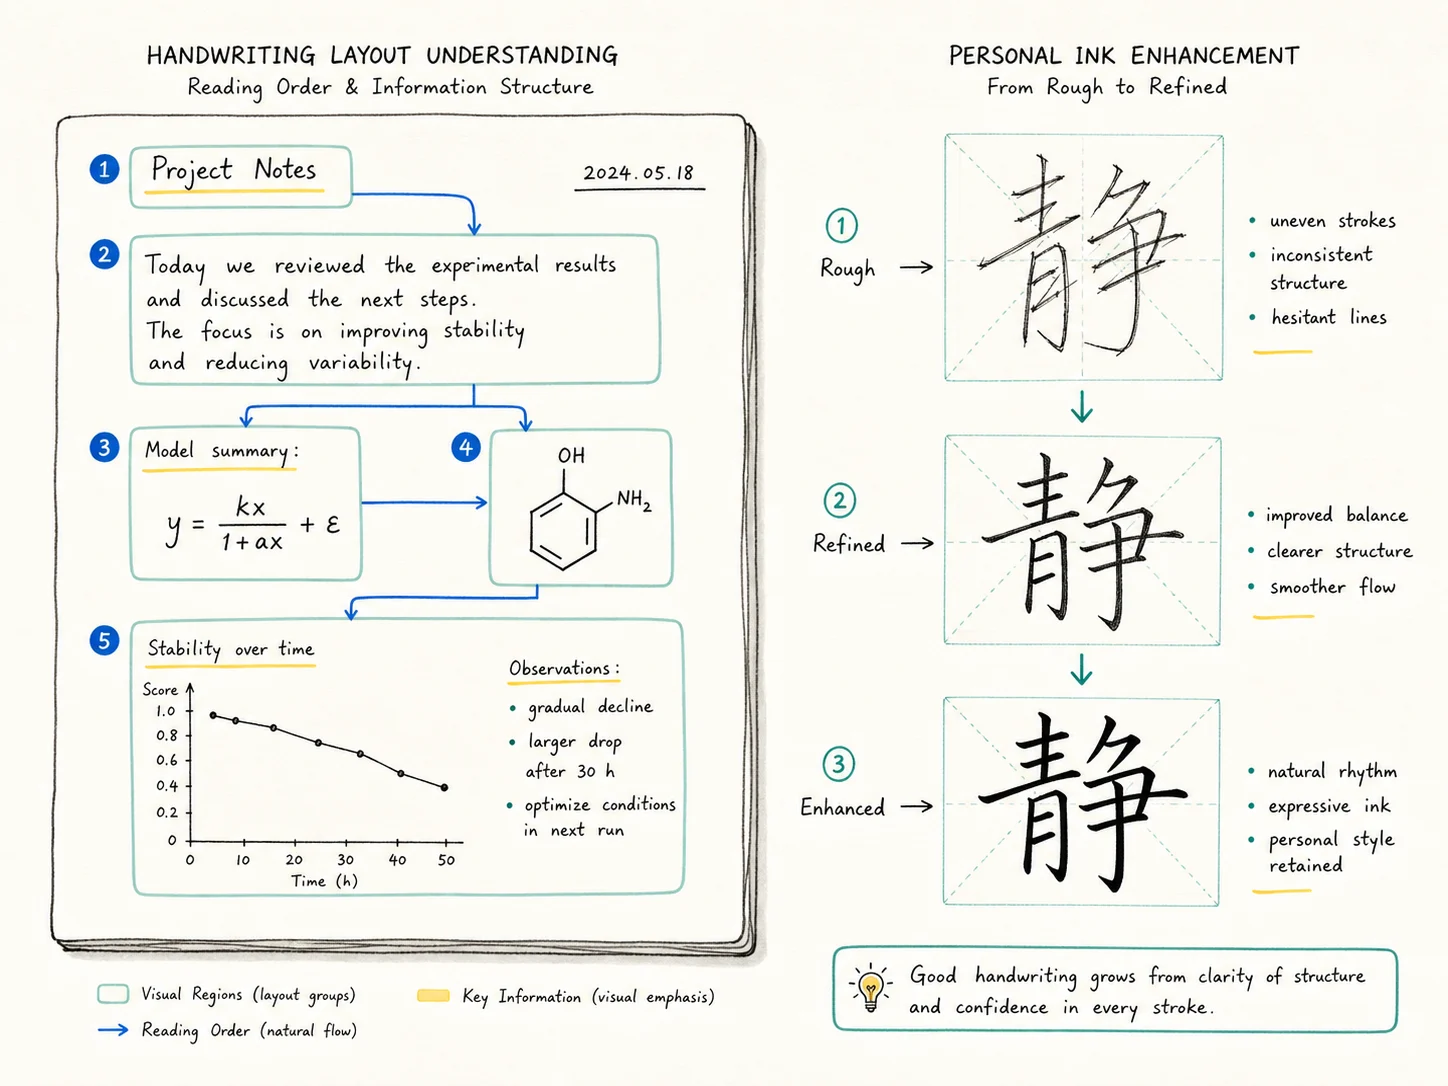
理解复杂笔记,也保留个人风格
复杂布局
一页笔记可能同时包含文字、公式、化学结构、图表和手绘标注。布局模型先给出区域、层级和阅读顺序,再由各专项识别器处理区域内容。
手写美化与个人笔迹
美化模块平滑抖动和毛刺,同时保留首尾、曲率和书写节奏;个人笔迹模块可从 1–2 个样字开始建立风格,15 个不同结构字用于获得更稳定的覆盖。
图片转笔迹
相册或相机图片先在本地提取近似可编辑轨迹,再送入文字、公式、简谱或布局识别。由于静态图片没有真实时间信息,结果明确标记为恢复轨迹,不冒充原始笔顺。
下一步:同一内核,多端一致
Android、iOS、Windows 与 HarmonyOS 共享同一 C++ 识别内核和模型合同。平台层只负责画布事件、线程、资源解密、授权和结果展示,算法能力不在各平台重复维护。
这让一次模型升级、一次安全加固和一次识别修复能够通过统一接口进入多个终端,同时保留每个平台原生的手写交互。